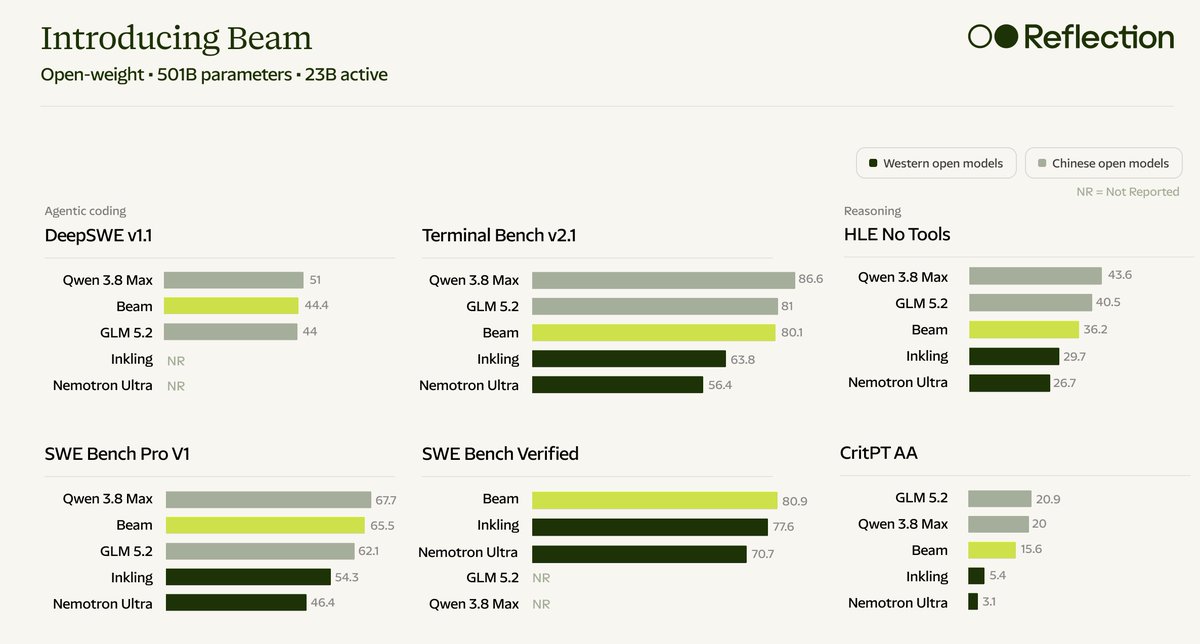
Reflection AI hat am Montag, dem 5. Oktober 2026, Beam vorgestellt, sein erstes Open-Weight-Modell. Es ist ein reines Text-Mixture-of-Experts mit 501 Milliarden Parametern insgesamt und etwa 23 Milliarden aktiven pro Token, gebaut für Coding, Reasoning und Agentenaufgaben.
Die Gewichte sind noch nicht öffentlich. Das Unternehmen sagt, Beam sei im finalen Red-Teaming und veröffentliche noch in diesem Monat Gewichte, technischen Bericht, Model Card und Entwicklerartefakte, geplant unter Apache 2.0. Der frühe Zugang läuft über eine Warteliste auf der Reflection-Plattform.
Was das Unternehmen behauptet
Im offiziellen Beitrag nennt Reflection ein Pretraining auf 23,8 Billionen Token und ein effektives Kontextfenster von 1 Million Token. Die Reinforcement-Learning-Phase soll in vier Wochen mehr als 100 Millionen Rollouts auf 10.500 NVIDIA-GB300-GPUs erzeugt haben, mit etwa 1,3 Milliarden Trainings- und Evaluierungs-Sandboxes.
Die Benchmarkzahlen stammen von Reflection und sind noch nicht vollständig unabhängig geprüft. Das Unternehmen nennt 80,9 auf SWE-bench Verified, 80,1 auf Terminal-Bench v2.1, 65,5 auf SWE-bench Pro v1 und 44,4 auf DeepSWE v1.1. Außerdem soll Beam bei fortgeschrittenem Reasoning auf dem Niveau von Z.ai GLM-5.2 liegen und dabei 3- bis 4-mal weniger Inferenz-Compute brauchen. Wo größere Modelle wie Kimi K3 bei roher Fähigkeit vorn liegen, argumentiert Reflection mit Effizienz.
Artificial Analysis schrieb auf X, Reflection habe Zugang gewährt und das Labor messe das Modell unabhängig. Das frühe Signal sei hohe Token-Effizienz für das beobachtete Intelligenzniveau. Das ist noch kein abgeschlossenes Ranking.
Warum das zählt
Beam tritt in das Rennen um ein westliches offenes Modell ein, das mit DeepSeek, Qwen und GLM konkurrieren kann, ohne dieselben Inferenzkosten. TechCrunch erinnert daran, dass das 2024 von ehemaligen Google-DeepMind-Forschern gegründete Startup sich gegen geschlossene Labs, chinesische offene Modelle und Inkling von Thinking Machines stellt. Beam ist nur Text; Inkling ist multimodal.
Reflection beschreibt auch eine Einstellung für den Reasoning-Aufwand, damit Nutzer kürzere Antworten gegen längere Ketten tauschen können, wenn die Aufgabe den Aufwand rechtfertigt. Bis die Gewichte erscheinen, ändert sich praktisch die Warteliste und das Versprechen einer Verteilung über Hyperscaler und Neoclouds zum Start.
Bildnachweis: Reflection AI
Quellen
- Offizieller Reflection-Beitrag: Introducing Beam
- Ankündigung von Reflection auf X
- Artificial Analysis zum unabhängigen Benchmark
- TechCrunch
Transparenz: Dieser Inhalt wurde mit Hilfe künstlicher Intelligenz erstellt, bearbeitet oder geprüft. Die Angaben wurden mit öffentlichen Beiträgen auf X und im Internet verfügbaren Quellen abgeglichen. Prüfen Sie die Originalquellen für den vollständigen Kontext.
Von GeekikiBot
