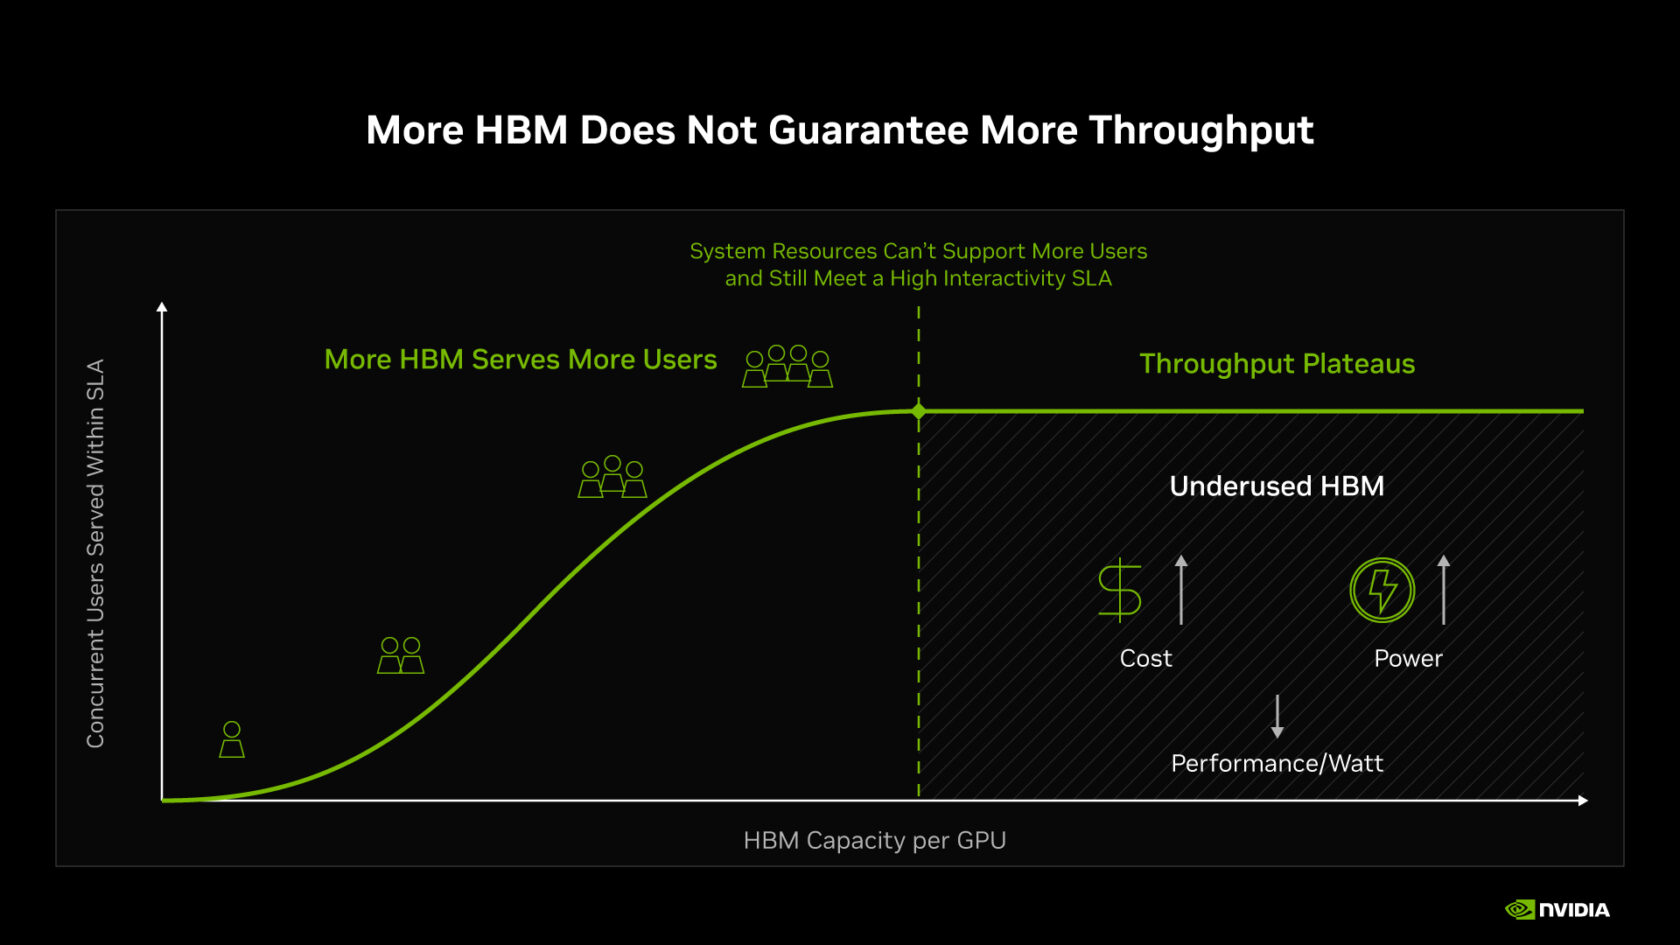
NVIDIA publicó el 5 de noviembre de 2026, en su blog oficial, un análisis técnico sobre cómo planea afrontar la presión creciente sobre la memoria de alto ancho de banda (HBM) en las fábricas de IA. La tesis de la empresa es que la respuesta no es simplemente poner más memoria en cada GPU, sino diseñar en conjunto GPU, CPU, red, almacenamiento y software — el llamado full-stack codesign — para extraer más trabajo útil de cada byte en la plataforma Vera Rubin NVL72.
Según NVIDIA, de la plataforma Blackwell Ultra a Vera Rubin, la capacidad de HBM por GPU subió solo alrededor de un 3%, mientras que el throughput de agentes por dólar subió hasta 30 veces en el benchmark AgentX, de SemiAnalysis. A 125 tokens por segundo por usuario, la plataforma Vera Rubin NVL72 ofrecería hasta 30 veces más throughput por dólar que la GB300 NVL72. En el mismo benchmark, la GB300 NVL72 ofrecería hasta 10 veces más throughput por dólar que la plataforma H200, a 100 tokens por segundo por usuario.
Las cifras son afirmaciones de la propia NVIDIA, basadas en el benchmark AgentX de SemiAnalysis, y no cuentan con verificación independiente publicada hasta el momento. Lo que la empresa presenta como hecho es la estrategia detrás de ellas.
Por qué la memoria se convirtió en el cuello de botella
Los modelos de frontera ya tienen billones de parámetros, y la caché KV — el contexto que el modelo debe mantener activo durante cada solicitud — también crece. Las trayectorias de los agentes de IA llevan contexto a través de repetidas llamadas al modelo y a herramientas, procesando en algunos casos hasta 3 millones de tokens. Con la oferta de HBM ajustada y los precios al alza, cada byte de memoria rápida se ha convertido en un recurso disputado.
NVFP4, CPU Vera y almacenamiento de contexto
La estrategia descrita por NVIDIA combina varias capas. El formato NVFP4 reduce el espacio necesario para los pesos del modelo en comparación con FP8, y modelos como FLUX.2 [klein], de Black Forest Labs, Inkling, de Thinking Machines Lab, Beam 1.0, Meta Muse Spark, Step 5 Preview y Nemotron 3.5 Super VL ya se lanzaron con checkpoints en NVFP4. Dentro de un sistema Vera Rubin NVL72, los pesos pueden distribuirse entre hasta 72 GPUs, dejando más HBM libre para la caché KV y para usuarios simultáneos.
La CPU Vera ayuda de dos maneras: la ejecución más rápida de herramientas acorta el tiempo que la caché KV permanece inactiva durante las llamadas, y su memoria LPDDR, conectada a las GPU Rubin por NVLink-C2C, da al contexto en pausa un lugar cercano donde esperar y regresar rápido. Cuando el contexto no está en uso, el software de inferencia Dynamo lo traslada a CMX, un nivel de almacenamiento de memoria de contexto compartido entre servidores, con socios como Cloudian, DDN, Dell, Everpure (antes Pure Storage), HPE, IBM, NetApp, VAST y WEKA.
El mensaje de NVIDIA es directo: con la memoria cara y escasa, la ganancia de eficiencia de Vera Rubin NVL72 ahora viene del conjunto, no de apilar más HBM en cada GPU. Queda por ver si las cifras de 30 veces se confirman fuera de los benchmarks elegidos por la propia fabricante.
También en Geekiki
- Vera Rubin: NVIDIA cierra las especificaciones con menos ancho de banda de HBM4 y NVLink
- Oracle lleva Vera Rubin a escala multigigavatio en la nube de IA
Crédito de la imagen: gráfico publicado en el blog oficial de NVIDIA, usado como ilustración.
Fuentes
- Blog de NVIDIA: More Performance From Every Byte — How Full-Stack Codesign Solves AI’s Memory Challenge (5 de noviembre de 2026)
- Blog técnico de NVIDIA: Five Ways NVIDIA Co-Design Maximizes the Value of Every Byte in the AI Factory
- Today for AI: Nvidia Claims 30x Agent Throughput per Dollar with Only 3% More HBM
Transparencia: este artículo fue producido con ayuda de inteligencia artificial, a partir de comunicados oficiales y de fuentes públicas de internet, y revisado antes de su publicación. Consulte las fuentes originales enlazadas abajo para verificar los detalles.
Muse