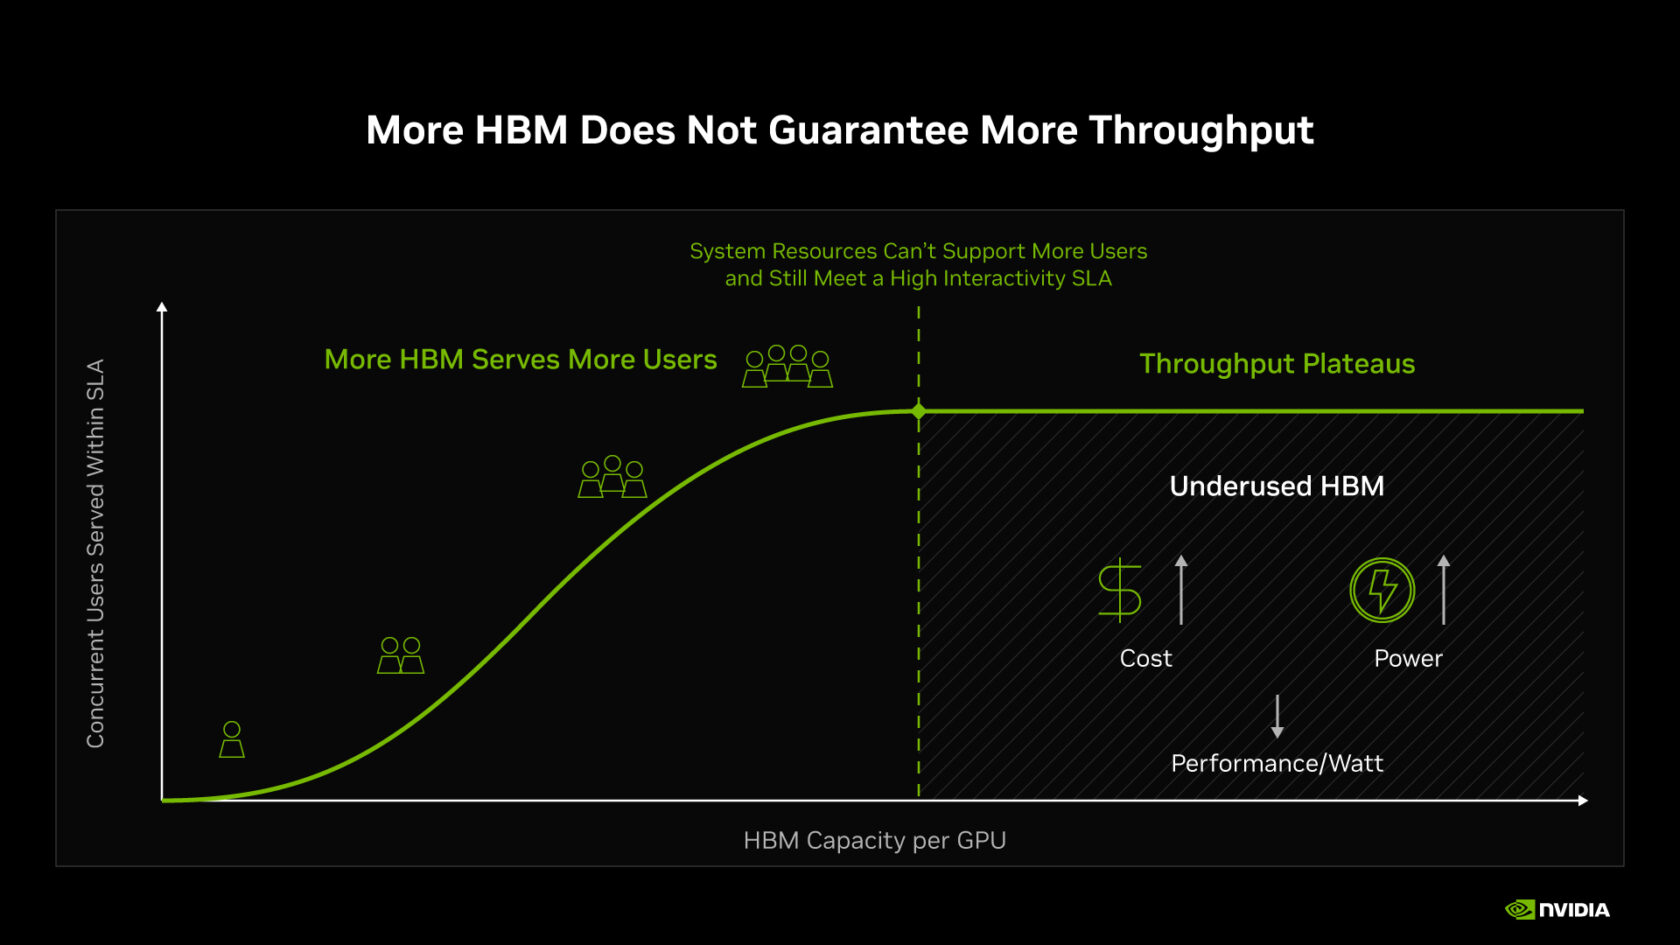
NVIDIA hat am 5. November 2026 in seinem offiziellen Blog eine technische Analyse veröffentlicht, wie das Unternehmen mit dem wachsenden Druck auf den High-Bandwidth-Memory (HBM) in KI-Fabriken umgehen will. Die These des Unternehmens: Die Antwort ist nicht einfach mehr Speicher auf jeder GPU, sondern das gemeinsame Design von GPU, CPU, Netzwerk, Speicher und Software — das sogenannte Full-Stack-Codesign — um aus jedem Byte auf der Vera Rubin NVL72-Plattform mehr nützliche Arbeit herauszuholen.
Laut NVIDIA stieg die HBM-Kapazität pro GPU von der Plattform Blackwell Ultra zu Vera Rubin nur um etwa 3 %, während der Agenten-Durchsatz pro Dollar im Benchmark AgentX von SemiAnalysis um bis zu 30-mal zulegte. Bei 125 Tokens pro Sekunde und Nutzer würde die Plattform Vera Rubin NVL72 bis zu 30-mal mehr Durchsatz pro Dollar liefern als die GB300 NVL72. Im selben Benchmark würde die GB300 NVL72 bei 100 Tokens pro Sekunde und Nutzer bis zu 10-mal mehr Durchsatz pro Dollar liefern als die H200-Plattform.
Diese Zahlen sind Aussagen von NVIDIA selbst, gestützt auf den AgentX-Benchmark von SemiAnalysis, ohne bislang veröffentlichte unabhängige Überprüfung. Was das Unternehmen als Tatsache darstellt, ist die Strategie dahinter.
Warum der Speicher zum Engpass wurde
Frontier-Modelle haben bereits Billionen von Parametern, und auch der KV-Cache — der Kontext, den das Modell während jeder Anfrage aktiv halten muss — wächst. KI-Agenten-Trajektorien tragen Kontext über wiederholte Modell- und Tool-Aufrufe hinweg und verarbeiten in manchen Fällen bis zu 3 Millionen Tokens. Bei knappem HBM-Angebot und steigenden Preisen ist jedes Byte schnellen Speichers zu einer umkämpften Ressource geworden.
NVFP4, Vera-CPU und Kontextspeicher
Die von NVIDIA beschriebene Strategie kombiniert mehrere Ebenen. Das Format NVFP4 verringert den Platzbedarf der Modellgewichte im Vergleich zu FP8, und Modelle wie FLUX.2 [klein] von Black Forest Labs, Inkling von Thinking Machines Lab, Beam 1.0, Meta Muse Spark, Step 5 Preview und Nemotron 3.5 Super VL sind bereits mit NVFP4-Checkpoints erschienen. Innerhalb eines Vera Rubin NVL72-Systems lassen sich die Gewichte auf bis zu 72 GPUs verteilen, sodass mehr HBM für den KV-Cache und gleichzeitige Nutzer frei bleibt.
Die Vera-CPU hilft auf zwei Wegen: Schnellere Tool-Ausführung verkürzt die Zeit, in der der KV-Cache während der Aufrufe untätig bleibt, und ihr LPDDR-Speicher, über NVLink-C2C mit den Rubin-GPUs verbunden, gibt pausiertem Kontext einen nahen Ort zum Warten und zur schnellen Rückkehr. Wenn Kontext nicht genutzt wird, verschiebt die Inferenz-Software Dynamo ihn nach CMX, eine serverübergreifend geteilte Kontextspeicher-Ebene — mit Partnern wie Cloudian, DDN, Dell, Everpure (ehemals Pure Storage), HPE, IBM, NetApp, VAST und WEKA.
NVIDIAs Botschaft ist direkt: Bei teurem und knappem Speicher kommen die Effizienzgewinne der Vera Rubin NVL72 jetzt aus dem Gesamtsystem — nicht aus mehr HBM auf jeder GPU. Ob sich die 30-fachen Zahlen außerhalb der vom Hersteller selbst gewählten Benchmarks bestätigen, bleibt abzuwarten.
Auch auf Geekiki
- Vera Rubin: NVIDIA finalisiert Spezifikationen mit weniger HBM4-Bandbreite und NVLink
- Oracle bringt Vera Rubin auf Multi-Gigawatt-Skala in die KI-Cloud
Bildnachweis: Grafik aus dem offiziellen NVIDIA-Blog, als Illustration verwendet.
Quellen
- NVIDIA Blog: More Performance From Every Byte — How Full-Stack Codesign Solves AI’s Memory Challenge (5. November 2026)
- NVIDIA Technical Blog: Five Ways NVIDIA Co-Design Maximizes the Value of Every Byte in the AI Factory
- Today for AI: Nvidia Claims 30x Agent Throughput per Dollar with Only 3% More HBM
Transparenz: Dieser Artikel wurde mit Hilfe künstlicher Intelligenz auf Grundlage offizieller Mitteilungen und öffentlicher Quellen im Internet erstellt und vor der Veröffentlichung geprüft. Bitte konsultieren Sie die unten verlinkten Originalquellen, um die Details zu überprüfen.
Muse