A Universidade Tsinghua, a AgiBot e a Infinigence AI apresentaram em 30 de outubro de 2026 o CEL (Collective Experience Learning), um método em que robôs aprendem com a experiência uns dos outros, em vez de depender apenas de demonstrações humanas. CONFIRMADO: o anúncio e os números abaixo vêm da página oficial do projeto e do relatório técnico publicado no arXiv, com cobertura da imprensa chinesa no mesmo dia.
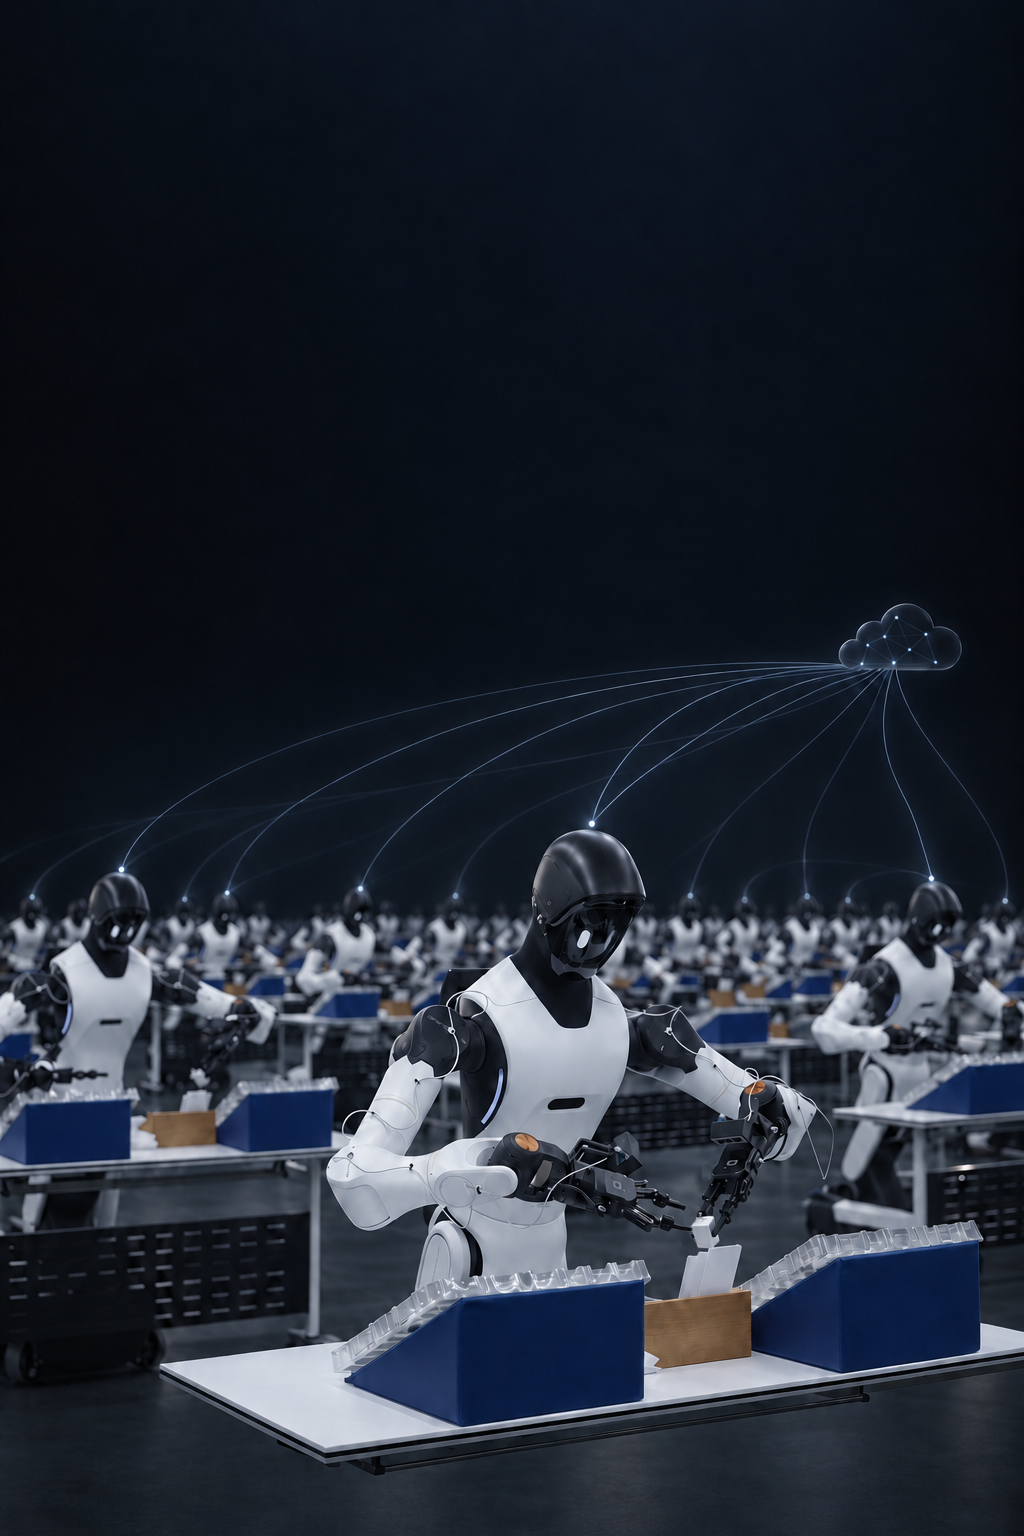
A ideia central é simples de entender e difícil de executar: cada robô registra o que deu certo e o que deu errado durante o trabalho real. Os acertos entram em um acervo coletivo e passam a servir de referência para os demais. Assim, um robô que tropeça em uma etapa pode recuperar um trecho bem-sucedido de um colega em situação parecida, em vez de esperar que um especialista demonstre a correção.
Como o aprendizado coletivo funciona
Dois componentes sustentam o método. O FERT (Failure-guided Experience Retrieval Fine-Tuning) usa os contextos de falha como consulta para encontrar experiências de sucesso e priorizá-las no treinamento. O FATS (Fault-tolerant Asynchronous Training System) mantém a coleta em andamento mesmo quando robôs individuais saem do ar, com recuperação local pelo sistema HotSwarm e coordenação de dados pelo SwarmLink.
Cinco tarefas reais e o efeito de escala
O teste usou cinco tarefas reais: arranjo de flores, dobrar roupas, carregar celular, montar um banco e embalar um celular. As políticas foram avaliadas em dois robôs AgiBot G2 que não participaram da coleta de treinamento, com 60 testes por robô e sem intervenção humana. Segundo o projeto, a taxa média de sucesso chegou a 97,3% após o aprendizado coletivo.
O caso mais forte é o da embalagem de celular, uma tarefa industrial longa, com várias etapas em sequência. Nela, a taxa de sucesso subiu de 79,2% para 98,3% em 120 testes, e as falhas caíram de 25 para 2. No carregamento de celular, o salto foi de 60,0% para 97,5%. O projeto também relata um efeito de escala: mantendo o tempo de coleta por robô, ampliar a frota de treinamento de 16 para 96 robôs elevou o sucesso na embalagem de 86,7% para 98,3%.
A operação em escala também foi medida. Em uma corrida com 96 robôs, a frota coletou 9.834 episódios apesar de 30 incidentes de falha em 22 robôs, com custo estimado de apenas 1,3% do tempo total de operação. É um dado relevante porque frotas grandes tendem a falhar mais em números absolutos; o ponto do sistema é impedir que uma falha local pare todo o aprendizado.
O limite que precisa ficar claro
Há um limite importante, e ele deve ser lido com clareza: os resultados são os divulgados pela própria equipe, ainda sem reprodução independente. Humanos também seguem no processo, fornecendo rótulos de sucesso ou falha, reiniciando ambientes e supervisionando a fase inicial. O CEL reduz a dependência de demonstrações de especialistas, mas não elimina a supervisão humana.
Leia também a cobertura do Geekiki sobre outro avanço da AgiBot: AGIBOT GO-3 Preview: robô que aprende com a experiência.
Para o público do Geekiki, o valor está na mudança de gargalo. Se a experiência de uma frota puder ser reaproveitada com segurança, treinar robôs para tarefas físicas pode ficar menos dependente de horas escassas de especialistas — e mais próximo de um processo em que a prática coletiva, medida em tarefas reais, vira o próprio material de aprendizado.
Crédito da imagem: projeto CEL, de Tsinghua University, AgiBot e Infinigence AI.
Fontes: Projeto CEL: Learning from Fleet Experience; Relatório técnico no arXiv; PE Daily, 30 de outubro de 2026; Sina Finance / Beijing News Shell Finance, 30 de outubro de 2026
Transparência: esta matéria foi produzida com auxílio de inteligência artificial, a partir do cruzamento de publicações públicas e de fontes da internet. Os resultados apresentados são os divulgados pela equipe do projeto e ainda não passaram por reprodução independente. Consulte as fontes originais para verificar os detalhes.
Muse