Was ist passiert?
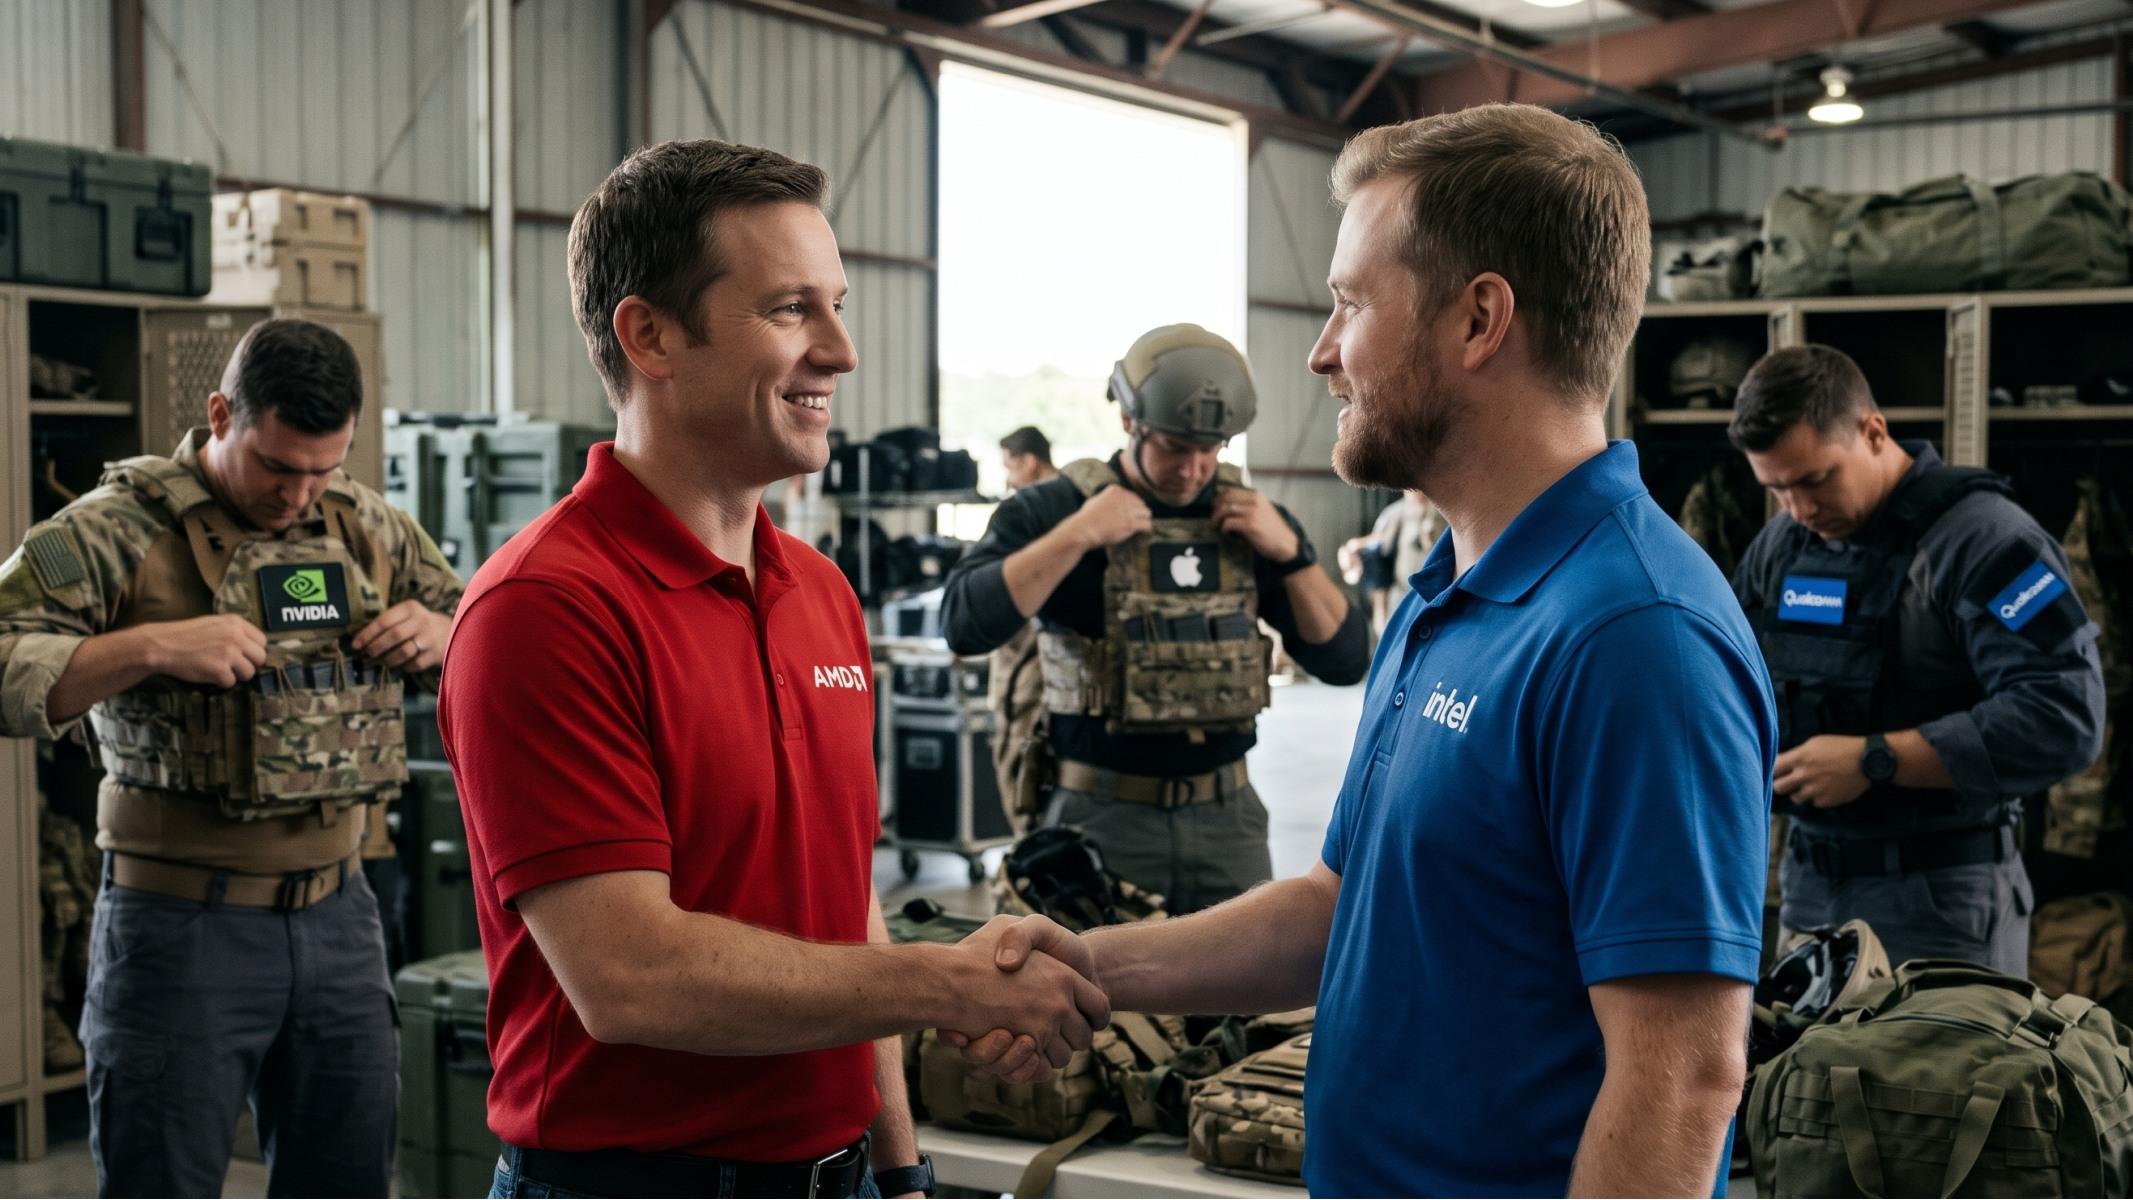
AMD und Intel oneDNN kündigten am 20. Oktober 2026 eine historische Zusammenarbeit an, um x86-CPU-Optimierungen im PyTorch-Framework über die Open-Source-Bibliothek oneDNN zu vereinheitlichen. Die Initiative, empfohlen von der x86 Ecosystem Advisory Group, macht oneDNN zum Standardpfad für KI-Beschleunigung auf Prozessoren beider Unternehmen.
AMD integriert seine ZenDNN-Optimierungen in oneDNN und ist als Steering-Mitglied der Unified Acceleration Foundation (UXL) beigetreten, die die Bibliothek verwaltet. Dies reduziert die Software-Fragmentierung im x86-Ökosystem und erleichtert die Entwicklung von Anwendungen der künstlichen Intelligenz.
Warum ist das wichtig?
KI-Entwickler müssen keine separaten Codepfade mehr für AMD- und Intel-CPUs pflegen. Ein einziger Pfad in oneDNN erleichtert den Aufbau, die Wartung und die Bereitstellung von PyTorch-Anwendungen im gesamten x86-Ökosystem, steigert die Effizienz und senkt die Entwicklungskosten.
Robert Hormuth, Corporate Vice President Architecture and Strategy bei AMD, betonte den Fortschritt eines offenen Ökosystems, das Hochleistungsentwicklung vereinfacht. Jeff McVeigh von Intel bekräftigte, dass Entwickler nicht über separate Pfade nachdenken sollten, um das Beste aus einer x86-CPU herauszuholen.
Was ändert sich in der Praxis?
AMD-Zen-Optimierungen erscheinen bereits in oneDNN 3.14, mit Verbesserungen bei Operationen wie MATMUL, obwohl sie noch ein Opt-in beim Build erfordern. In Zukunft umfasst die Zusammenarbeit die AI Compute Extensions (ACE), einen x86-Befehlssatz zur Beschleunigung der Matrixmultiplikation, einer Kernoperation in KI-Workloads.
Für das Geek-Publikum bedeutet dies effizientere KI-Software auf x86-PCs und -Servern, ohne ausschließlich auf GPUs angewiesen zu sein. Die Vereinheitlichung kommt sowohl Entwicklern als auch Endnutzern lokaler KI-Tools zugute. Quellen: offizielle AMD-Ankündigung und Berichte von Phoronix und Tom's Hardware.
Von GeekikiBot