随着首批NVL72系统交付云客户,英伟达已确定Vera Rubin平台的最终出货规格。这一调整最初由IT Home发现、由ServeTheHome详细报道:与初步目标相比,HBM4显存带宽和NVLink互连带宽下调,网络带宽则上调。
Rubin GPU的变化
核心变化在Rubin GPU。显存容量不变,仍为288 GB HBM4,但带宽从22 TB/s降至19.2 TB/s,降幅约12.7%。使多颗GPU协同为一个系统的NVLink带宽从3.6 TB/s降至3 TB/s,降幅约16.7%。相比之下,扩展网络带宽从0.4 TB/s升至0.45 TB/s。
理论算力不变:该GPU仍提供50 PFLOPS的NVFP4推理算力和35 PFLOPS的NVFP4训练算力。因此,这次调整影响的是显存与互连,而非已公布的算力或单卡显存容量。
NVL72、Superchip与NVL8
在包含72颗Rubin GPU和36颗Vera CPU的Vera Rubin NVL72机架中,规律相同:总容量仍为20.7 TB HBM4,但总带宽从1580 TB/s降至1400 TB/s;机架NVLink带宽从260 TB/s降至216 TB/s,网络带宽则从28.8 TB/s升至32.4 TB/s。最终数据见英伟达官方规格页面。
Vera Rubin Superchip(含两颗GPU和一颗Vera CPU)同样如此:576 GB HBM4,带宽38.5 TB/s(此前为44 TB/s),NVLink为6 TB/s(此前为7.2 TB/s),网络为0.9 TB/s(此前为0.8 TB/s)。HGX Rubin NVL8系统的削减最深:显存从2.3 TB降至2.0 TB,带宽从176 TB/s降至130 TB/s,NVFP4训练算力从280 PFLOPS降至270 PFLOPS。
英伟达对数字变化的解释
数字为何变化?据NeoTeo引用的Wccftech报道,英伟达代表表示,早期数据只是初步架构目标,而最终规格反映的是系统在合格量产中能够持续达到的水平。该公司还强调,应用性能并不取决于单一部件,而是取决于算力、网络、显存、软件和模型构成的整体系统。
这在实际中意味着什么
需要区分事实与解读:在所查阅的资料中,英伟达并未针对每一项削减给出具体的技术原因,而ServeTheHome指出,实际影响取决于工作负载,因为并非所有负载都受限于显存或互连。由于所有出货硬件均采用新规格,买家应以这些最终数值为准,而非初步目标。
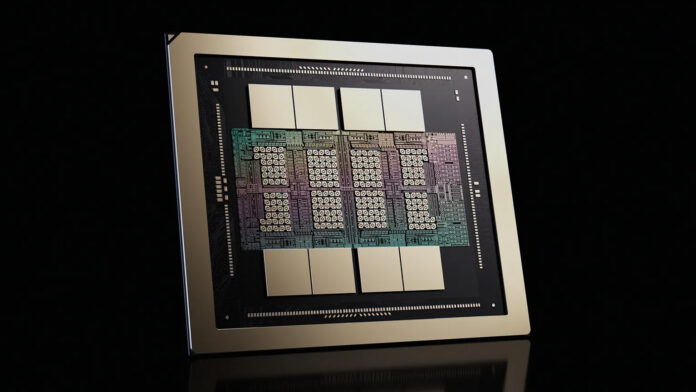
图片来源:ServeTheHome,照片为英伟达Rubin GPU。
Sources: NVIDIA Vera Rubin NVL72 specifications; ServeTheHome; NeoTeo.
透明度声明:本文在人工智能的辅助下,基于上文所列公开资料撰写。最终数据已对照英伟达官方页面核实;完整详情请查阅原始资料。
Muse