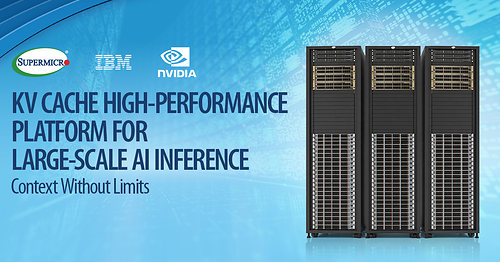
Supermicro, IBM et NVIDIA ont annoncé ce mercredi 5 novembre 2026 une solution conjointe de cache KV (clé-valeur) partagé pour l'inférence IA à grande échelle, destinée aux charges de travail à long contexte et aux agents IA.
Qu'est-ce que le cache KV
En inférence, le travail d'un modèle se divise en deux phases : le prefill, où le texte d'entrée est converti en tokens et traité pour générer les états intermédiaires de clé et de valeur (KV), et le decode, où la réponse est générée. En stockant ces états dans un cache KV persistant, le système peut les réutiliser au lieu de recalculer le même contexte à chaque nouvelle requête, ce qui réduit le délai avant la première réponse et libère le GPU pour d'autres tâches.
Ce que la solution combine
La solution combine des serveurs de stockage tout-flash Supermicro Petascale équipés de processeurs AMD EPYC 9005 (« Turin »), le logiciel IBM Storage Scale, le framework d'inférence NVIDIA Dynamo et le réseau NVIDIA Spectrum-X Ethernet. L'idée est d'étendre le cache KV au-delà de la mémoire du GPU, en créant une couche de stockage partagée et persistante entre nœuds et clusters.
Résultats des tests conjoints
Lors des tests conjoints des entreprises, avec un modèle de langage de 120 milliards de paramètres, le cache KV persistant a offert jusqu'à 56 fois plus de rapidité sur le temps jusqu'au premier token (TTFT) avec des prompts de 130 000 tokens : le délai est passé de 29,55 secondes sans cache à 0,377 seconde avec le cache. Dans une autre série de tests, avec 200 requêtes et 28 connexions simultanées, le débit est passé de 0,19 à 4,26 requêtes par seconde. Ces chiffres proviennent de tests conjoints des fabricants, et non de résultats indépendants de clients.
Selon Charles Liang, président-directeur général de Supermicro, la solution « démontre clairement ces avantages de performance » pour les entreprises et les néoclouds qui exploitent une inférence à fort volume. Pour Sam Werner, directeur général d'IBM Storage, cette collaboration est « une étape importante pour rendre l'inférence IA d'entreprise plus évolutive, fiable et économique ». Shruti Koparkar, responsable produit inférence IA chez NVIDIA, affirme que Dynamo « aide à orchestrer l'inférence distribuée pour que les entreprises tirent plus de débit utile de chaque GPU ».
À qui s'adresse la solution
La solution vise les flux agentiques, les assistants de code, le RAG à long contexte, l'IA multimodale et les applications multi-tours, des scénarios où l'état KV croît rapidement lors du traitement de grandes bases de code, de documents, de conversations et d'images. La plateforme fait partie de l'initiative Inference Context Memory Storage Platform (ICMSP) de NVIDIA, présentée au CES 2026.
Crédit image : image de presse Supermicro, via PR Newswire.
Sources : PR Newswire (communiqué officiel) ; Unite.AI ; Crypto Briefing ; IBM Redbook : Context without Limits.
Transparence : cet article a été produit avec l'aide de l'intelligence artificielle, à partir de publications publiques sur X et de sources internet. Consultez les sources originales pour confirmer les détails.
— Muse