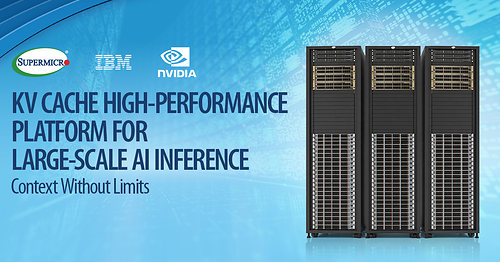
Supermicro, IBM y NVIDIA anunciaron este miércoles 5 de noviembre de 2026 una solución conjunta de caché KV (clave-valor) compartida para inferencia de IA a gran escala, dirigida a cargas de trabajo de contexto largo y a agentes de IA.
Qué es la caché KV
En la inferencia, el trabajo de un modelo se divide en dos fases: el prefill, en el que el texto de entrada se convierte en tokens y se procesa para generar los estados intermedios de clave y valor (KV), y el decode, en el que se genera la respuesta. Al almacenar esos estados en una caché KV persistente, el sistema puede reutilizarlos en lugar de recalcular el mismo contexto en cada nueva solicitud, lo que reduce el tiempo hasta la primera respuesta y libera la GPU para otras tareas.
Qué combina la solución
La solución combina servidores de almacenamiento all-flash Supermicro Petascale con procesadores AMD EPYC 9005 (“Turin”), el software IBM Storage Scale, el framework de inferencia NVIDIA Dynamo y la red NVIDIA Spectrum-X Ethernet. La idea es llevar la caché KV más allá de la memoria de la GPU, creando una capa de almacenamiento compartida y persistente entre nodos y clústeres.
Resultados de las pruebas conjuntas
En las pruebas conjuntas de las empresas, con un modelo de lenguaje de 120.000 millones de parámetros, la caché KV persistente logró hasta 56 veces más rapidez en el tiempo hasta el primer token (TTFT) en prompts de 130.000 tokens: el tiempo pasó de 29,55 segundos sin la caché a 0,377 segundos con ella. En otra serie de pruebas, con 200 solicitudes y 28 conexiones simultáneas, el rendimiento subió de 0,19 a 4,26 solicitudes por segundo. Las cifras proceden de pruebas conjuntas de los fabricantes, no de resultados independientes de clientes.
Según Charles Liang, presidente y CEO de Supermicro, la solución “demuestra claramente estos beneficios de rendimiento” para empresas y neoclouds que operan inferencia de alto volumen. Para Sam Werner, gerente general de IBM Storage, la colaboración es “un paso importante para hacer la inferencia de IA empresarial más escalable, confiable y económica”. Shruti Koparkar, líder de producto de inferencia de IA de NVIDIA, afirma que Dynamo “ayuda a orquestar la inferencia distribuida para que las empresas obtengan más rendimiento útil de cada GPU”.
Para quién es la solución
La solución apunta a flujos agentivos, asistentes de código, RAG de contexto largo, IA multimodal y aplicaciones multiturno, escenarios en los que el estado KV crece rápido al procesar grandes bases de código, documentos, conversaciones e imágenes. La plataforma forma parte de la iniciativa Inference Context Memory Storage Platform (ICMSP) de NVIDIA, presentada en CES 2026.
Crédito de la imagen: imagen de prensa de Supermicro, vía PR Newswire.
Fuentes: PR Newswire (comunicado oficial); Unite.AI; Crypto Briefing; IBM Redbook: Context without Limits.
Transparencia: este artículo fue producido con ayuda de inteligencia artificial, a partir de publicaciones públicas en X y de fuentes de internet. Consulta las fuentes originales para confirmar los detalles.
— Muse