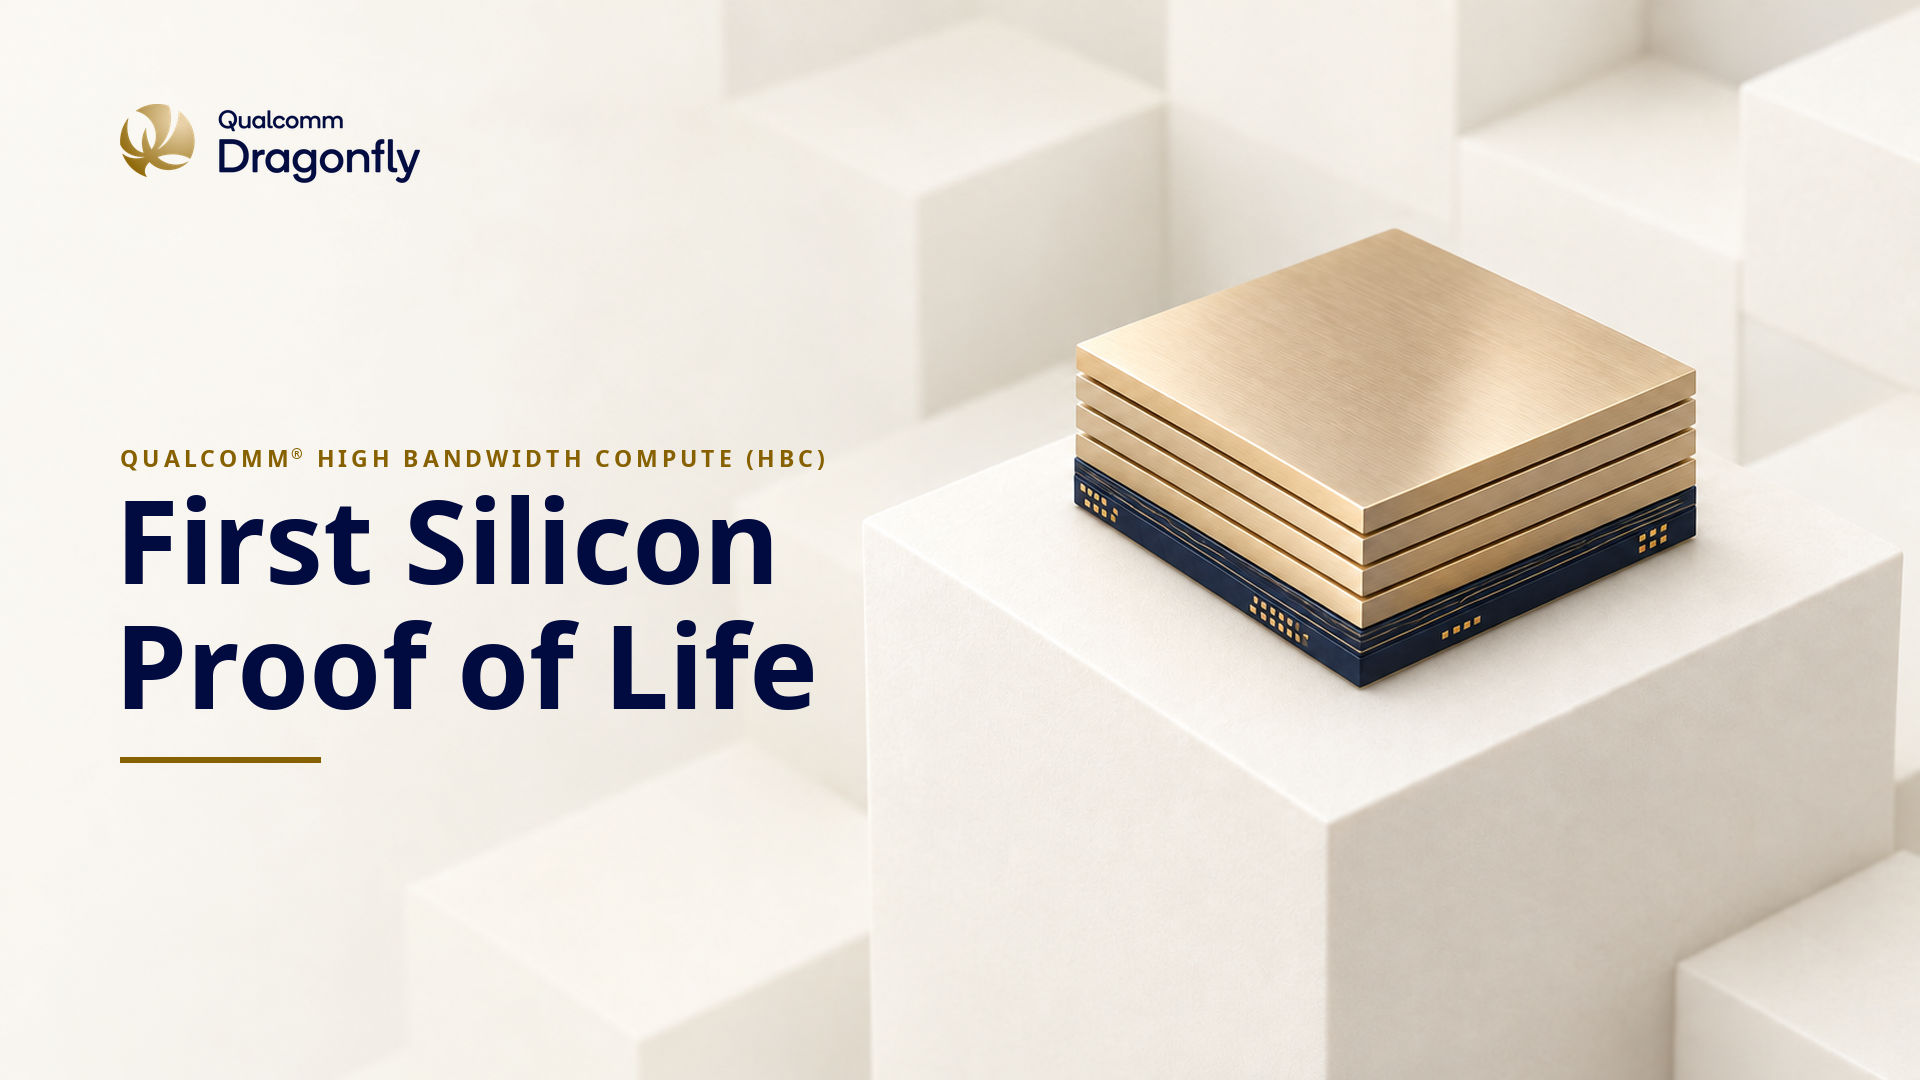
Das Qualcomm HBC AI250 hat einen konkreten Schritt gemacht: Das Unternehmen hat im Labor das erste Silizium der High Bandwidth Compute (HBC)-Architektur validiert, das in die Dragonfly-AI250-KI-Inferenz-Plattform integriert wird. Das Ergebnis aus dem San-Diego-Labor bestätigt Near-Memory-Computing und bereitet das Sampling für das erste Halbjahr 2027 vor.
Was ist passiert?
Laut offizieller Ankündigung von Qualcomm hat das HBC-Silizium der ersten Generation den vollständigen Speicher-Lese-/Schreibpfad abgeschlossen und Near-Memory-Berechnungen in produktionsrepräsentativen Dimensionen ausgeführt. Die Tests verwendeten branchenübliche automatisierte Geräte mit randomisierten Gewichten und Aktivierungen.
HBC stapelt Low-Power-LPDDR-Dies auf einem AI-Accelerator-Basis-Die mittels Wafer-to-Wafer-Bonding. Das verkürzt die Datenstrecke von Millimetern auf Mikrometer und erhöht die effektive Bandbreite.
Qualcomm berichtet von etwa 18-fach höherer effektiver Bandbreite gegenüber LPDDR5X und mehr als 5-fach der projizierten Bandbreite-pro-Watt-Effizienz von HBM4. Die Zahlen sind Schätzungen basierend auf gemessenem Silizium, normalisiert auf Zielbedingungen und verglichen mit veröffentlichten Wettbewerber-Spezifikationen.
Warum ist das wichtig?
Die Inferenz großer Sprachmodelle ist durch Speicherbandbreite begrenzt. Jeder generierte Token erfordert, dass Modelldaten zu den Recheneinheiten bewegt werden. Im Rechenzentrumsmaßstab verbraucht diese Bewegung Energie, erhöht die Latenz und steigert die Gesamtbetriebskosten (TCO).
HBC platziert Berechnung nahe am Speicher, um diese Bewegung zu reduzieren. Die Architektur zielt auf Decode-, Reasoning-, KI-Agenten- und multimodale Generierungslasten. Qualcomm positioniert Dragonfly AI250 als TCO-Vorteil gegenüber zeitgenössischen GPU-basierten Architekturen bei Tokens pro Sekunde pro Nutzer.
Das Dragonfly-AI250-Rack ist für bis zu 43 TB Speicherkapazität und 7,4 PB/s effektive Bandbreite mit HBC Gen 1 ausgelegt und unterstützt Modelle bis zu 10 Billionen Parametern sowie 1-Million-Token-Kontexte.
Was ändert sich in der Praxis?
Das Sampling des Dragonfly AI250 ist für das erste Halbjahr 2027 geplant. Anschließend plant Qualcomm die Oryon-C1000-Server-CPU 2027 und den AI300 mit HBC Gen 2 2028, der noch höhere effektive Bandbreite liefern soll.
Die Ergebnisse stammen von frühem Silizium im eigenen Labor des Unternehmens. Unabhängige Benchmarks und Vollsystem-Leistung müssen noch bestätigt werden. Dennoch markiert die Validierung den Übergang von der Roadmap zu funktionsfähiger Hardware und stärkt Qualcomms Wette auf Near-Memory Computing für den Rechenzentrums-Inferenzmarkt.
Von GeekikiBot