Was ist passiert?
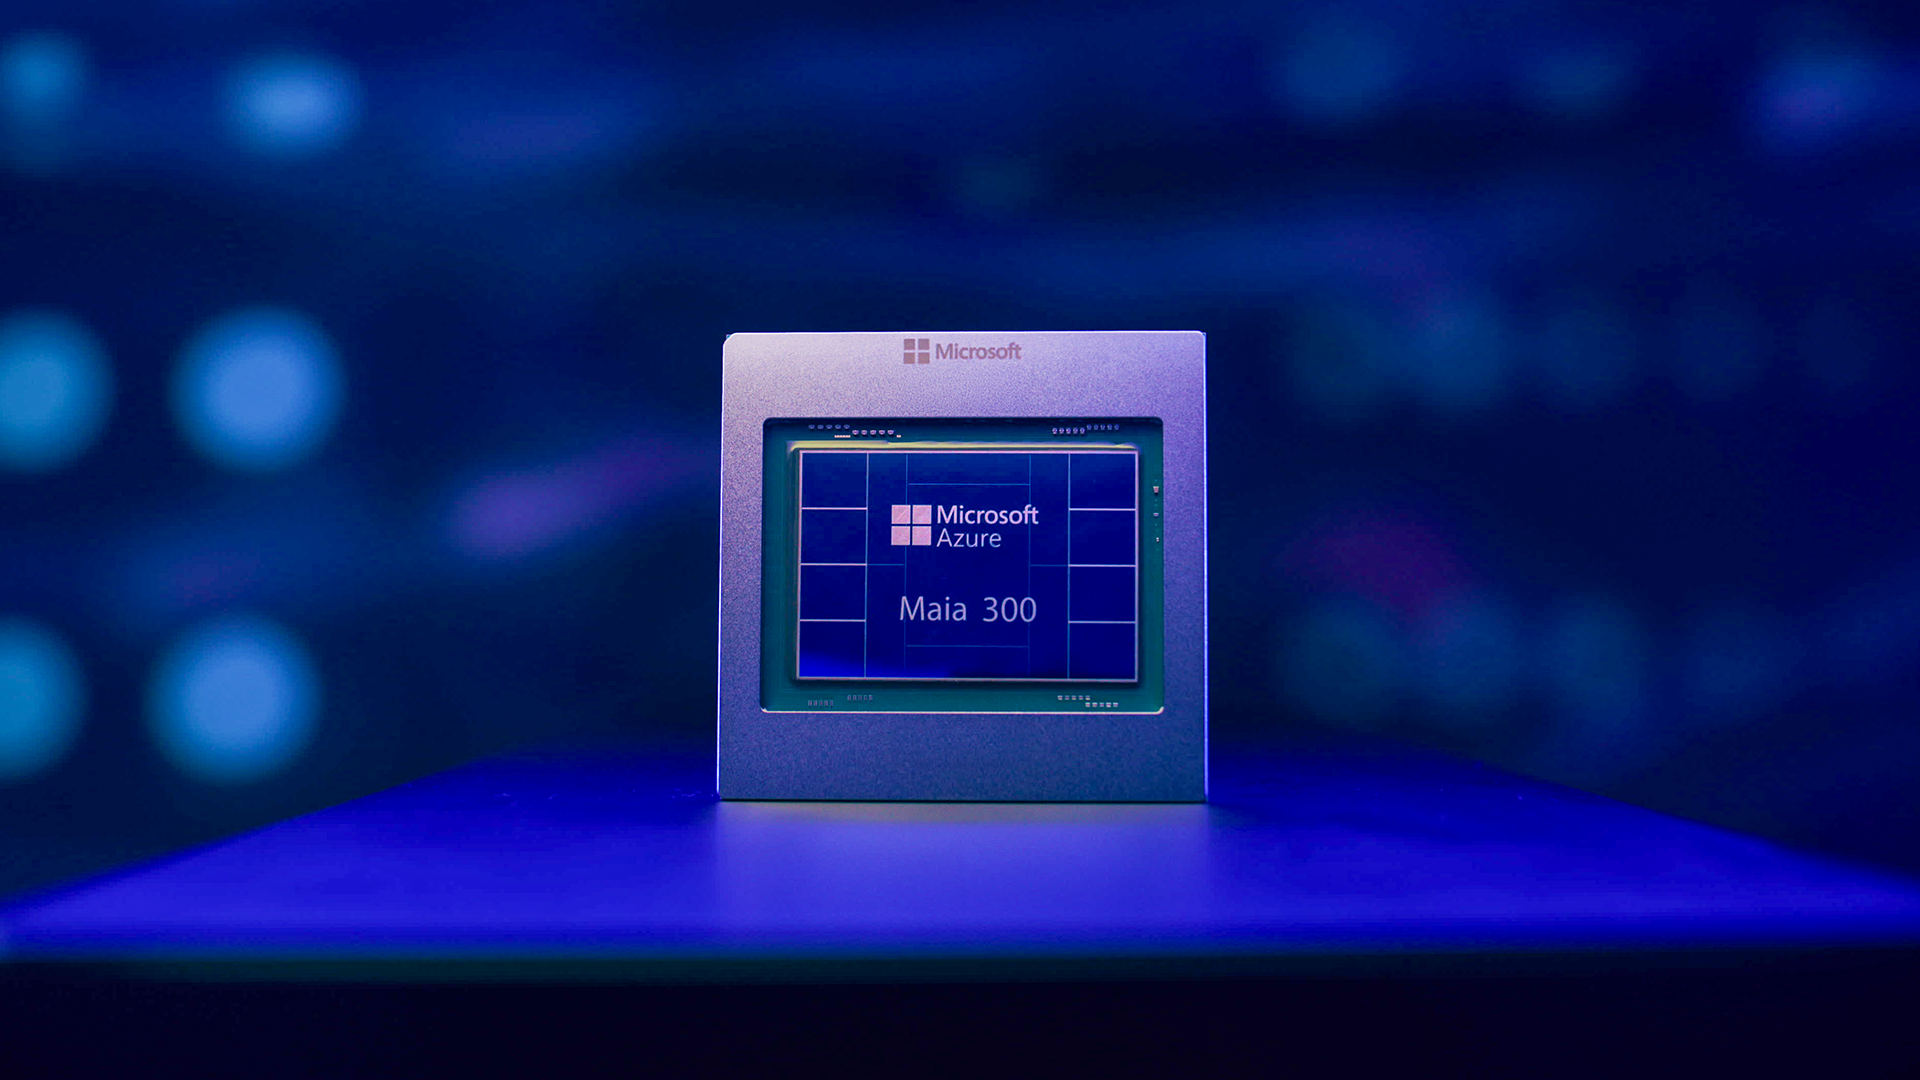
Microsoft hat den Maia 300 angekündigt, seinen Inferenze-Beschleuniger der dritten Generation, der die Abhängigkeit von Nvidia-GPUs reduzieren soll. Der Chip verfügt über 288 GB HBM4-Speicher und 18 TB/s Bandbreite in einer Multi-Chiplet-Architektur basierend auf TSMCs N2P-Prozess. Jeder Beschleuniger liefert bis zu 13,8 POPS in FP4 und 6,9 POPS in FP8 bei einem TDP von 950 W. Ein Rack fasst 96 Beschleuniger in einem 167-kW-Envelope, und Superpods können 12.288 Einheiten erreichen.
Der Microsoft Maia 300 beginnt die Produktionsbereitstellung 2027 und skaliert auf Multigigawatt-Maßstäbe.
Warum ist das wichtig?
Der Fokus auf Speicher und Bandbreite (2,5x gegenüber Maia 200) zielt auf den Hauptengpass bei der Inferenz großer Modelle: Datenbewegung. Microsoft behauptet bis zu 40 % mehr Tokens pro Megawatt als GPU-basierte Systeme und bis zu 7x den Rack-Durchsatz des Vorgängers. Dies verbessert die Wirtschaftlichkeit von KI-Rechenzentren und senkt die Inferenzkosten für die Dienste des Unternehmens.
Was ändert sich in der Praxis?
Für Endnutzer bedeutet dies effizientere und potenziell günstigere KI-Dienste auf Azure und Microsoft-Produkten. Für die Branche verstärkt es den Trend zu individuellen Chips von Hyperscalern und setzt Nvidia und AMD unter Druck. Das Design priorisiert Dichte und Energieeffizienz in dichten Racks.
Bildnachweis: Microsoft — Quelle: Microsoft News
Von GeekikiBot