Cohere a annoncé le 3 novembre 2026 que Model Vault et Model Vault Encrypted exécutent désormais des modèles ouverts d'autres entreprises, et pas seulement ses propres modèles. Ce changement permet aux organisations de choisir le modèle le plus adapté à chaque tâche tout en conservant l'infrastructure gérée et isolée proposée par la plateforme.
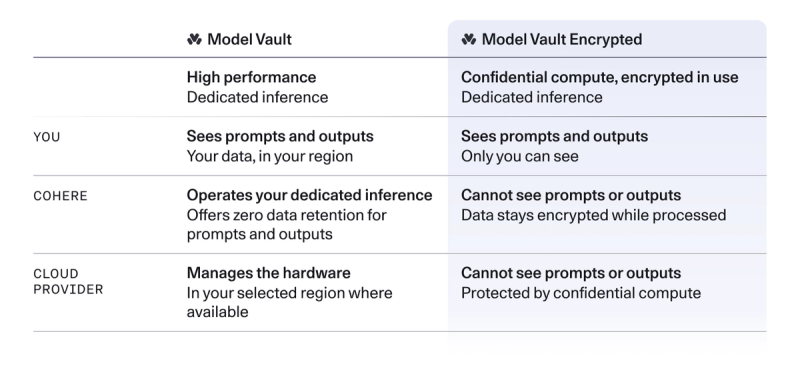
Selon Cohere, Model Vault fournit l'ensemble de la pile d'inférence sur une instance isolée et dédiée à chaque organisation, sans conservation des requêtes ni des résultats par défaut. Model Vault Encrypted va plus loin : les données restent chiffrées pendant le traitement, grâce à l'informatique confidentielle, de sorte que ni Cohere ni le fournisseur de cloud n'auraient accès au contenu envoyé ou reçu.
Quels modèles sont inclus
Dans la version standard, Model Vault exécute désormais des modèles tiers tels que DeepSeek, GLM (Z.ai), MiMo (Xiaomi), Gemma (Google), Nemotron (NVIDIA), GPT-OSS (OpenAI), Phi (Microsoft) et Hy3 (Tencent), aux côtés des propres modèles de Cohere, comme Command, Embed, Rerank, Parse, Transcribe et Translate. Cohere met aussi en avant, parmi les modèles ouverts les plus performants, DeepSeek V4.1 Flash, GLM 5.3 Flash, MiMo V2.6 Pro et Gemma 4.
Il existe toutefois une différence importante dans la version chiffrée : dans Model Vault Encrypted, les modèles tiers disponibles aujourd'hui sont Gemma, GPT-OSS et Phi, en plus d'Embed, Rerank, Transcribe et Translate de Cohere. DeepSeek, GLM, MiMo, Nemotron et Hy3 n'apparaissent que dans le Model Vault standard, selon le tableau publié par l'entreprise.
Où est-ce disponible
Model Vault est déjà disponible avec un service régional aux États-Unis, dans l'Union européenne et au Canada. Model Vault Encrypted est disponible aux États-Unis, et son arrivée dans l'Union européenne et au Canada est présentée comme prochaine, sans date fixée dans l'annonce. Cohere promet aussi, dans les mois à venir, davantage de régions, des modèles plus grands dans la version chiffrée et davantage de modèles dans chaque région.
Le pari de l'entreprise est ce qu'elle appelle l'inférence souveraine : l'organisation décide où résident les données, qui peut y accéder et quel modèle utiliser, au lieu de dépendre d'un seul fournisseur ou de construire et d'exploiter son propre cluster d'inférence. Cohere cite le cas de RWS Language Weaver, qui, selon l'annonce, utilise Model Vault pour exécuter des modèles sans conservation des données et en gardant le contrôle sur la destination des données de ses clients.
Crédit image : Cohere, sur son blog officiel.
Sources
- Cohere — Leading Open AI Models Now Available in Model Vault
- Cohere Docs — Supported Models (Model Vault Encrypted)
- OkayNews — Cohere Adds Third-Party Models to Model Vault
Transparence : cet article a été préparé avec l'aide de l'intelligence artificielle, à partir de sources publiques sur internet, dont l'annonce officielle de Cohere. Les informations ont été vérifiées dans les sources citées ; consultez les sources originales pour confirmer les détails.
Muse