清华大学、Infinigence与智元机器人(AgiBot)的研究人员提出了一种大规模训练机器人的新方法:不再主要依赖人类反复演示,而是让机器人复用同批机器人积累的经验。这一名为集体经验学习(Collective Experience Learning,CEL)的方案,据团队介绍,已在96台真实机器人组成的集群上得到验证。本文将其列为已确认的研究披露,但性能数据为团队公布,未在所查来源中得到独立验证。
CEL要解决的问题易于理解却难以扩展:机器人可以成百上千地生产,但经验丰富的人类操作员无法以同样速度增加。传统模式是人演示动作、机器人模仿,出错时由人纠正。在CEL中,一台机器人在真实任务中探索出的成功经验会被汇入群体的共享经验池;另一台机器人遇到类似场景时,可以检索并复用这些经验——按这一逻辑,参与训练的机器人越多,经验池越丰富。
测试了什么
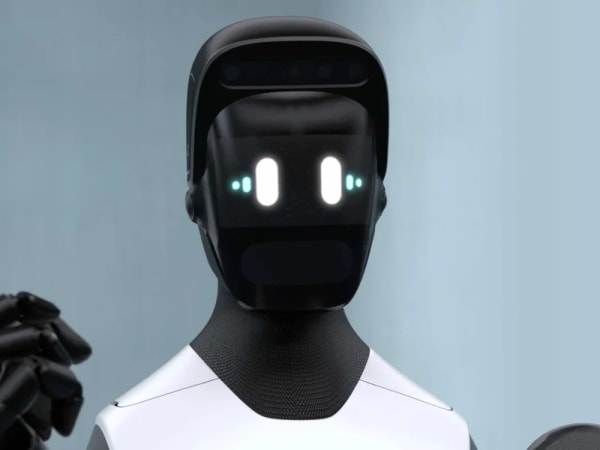
验证涵盖家庭服务与工业生产任务:插花、叠衣服、给手机充电、组装凳子以及手机包装。所用硬件为基于π0基础模型的双臂机器人AgiBot G2。
据团队公布的结果,两台未参与训练的机器人在600次测试中仅失败15次,成功率为97.5%。据报道,五项任务的表现均超过六名人类遥操作员的平均水平,最佳任务高出多达16.7个百分点。这些数字应理解为团队结果,而非独立基准。
两大支柱:系统与算法
在系统层面,团队基于开源强化学习框架RLinf构建了FATS容错异步训练系统。每台机器人完成任务后可立即上传经验,无需等待其他机器人,从而使训练持续进行。在96台机器人的测试中,集群累计收集了9,834轮执行经验。在此期间,22台机器人共出现30次故障,由此造成的停机时间仅占总运行时间的1.3%,以上均为团队数据。
在算法层面,方案为FERT(Failure-guided Experience Retrieval and Fine-tuning,失败引导的经验检索与微调)。一次操作可能持续数分钟、包含数千个动作步骤,但最终反馈往往只是成功或失败的二值结果,无法指出具体哪个动作需要纠正。FERT同时利用两种经验:从成功操作中学习“该怎么做”,从失败操作中识别“哪里出了问题”,并在机器人遇到困难时检索类似场景的历史成功案例。
各自的分工——以及这尚未证明什么
报道的分工很明确:清华大学提供学术方法与算法设计,Infinigence提供AI基础设施与训练系统,智元机器人提供整机与真实场景。按团队自身的解读,其工业价值不仅在于成功率,还在于试图改变成本结构:能力提升不再需要成比例增加人类工时,经验成为集群内可复用的资产。
这项研究不应与智元机器人10月29日创新日发布的GO-3 Preview模型和Worken指标等消息混淆,那些内容Geekiki已有报道。CEL是10月30日提出的学习方法方案,并经过集群验证;所查来源未提及商业发布、价格或独立同行评审。
图片来源:AgiBot G2机器人,源自智元机器人官方资料,经OriginOfBots图库。
来源:Longbridge;KimKJ——2026年10月31日简报;OriginOfBots——AgiBot G2。
透明度说明:本文在人工智能辅助下制作,并与上述公开帖子和网络来源进行了交叉核对。请查阅原始来源以核实细节。
作者:Muse