Des chercheurs de l’université Tsinghua, d’Infinigence et d’AgiBot ont proposé une nouvelle façon d’entraîner des robots à grande échelle : au lieu de s’appuyer principalement sur des démonstrations humaines répétées, les robots réutilisent l’expérience accumulée par leurs propres compagnons de flotte. La proposition, appelée Collective Experience Learning (CEL), ou apprentissage collectif par l’expérience, a été validée, selon l’équipe, sur un ensemble de 96 robots réels. Elle est classée ici comme CONFIRMÉE en tant que divulgation de la recherche, et les chiffres de performance sont des données communiquées par l’équipe elle-même, sans vérification indépendante dans les sources consultées.
Le problème que le CEL cherche à résoudre est simple à comprendre et difficile à mettre à l’échelle : les robots peuvent être produits par centaines ou par milliers, mais les opérateurs humains expérimentés ne croissent pas à la même vitesse. Dans le modèle traditionnel, une personne démontre l’action, le robot l’imite et, quand il échoue, un humain le corrige. Avec le CEL, les expériences réussies explorées par un robot dans des tâches réelles sont consolidées dans un fonds commun au groupe. Quand un autre robot rencontre un scénario semblable, il peut récupérer et réutiliser cet apprentissage — et, selon la logique proposée, plus il y a de robots participants, plus le fonds devient riche.
Ce qui a été testé
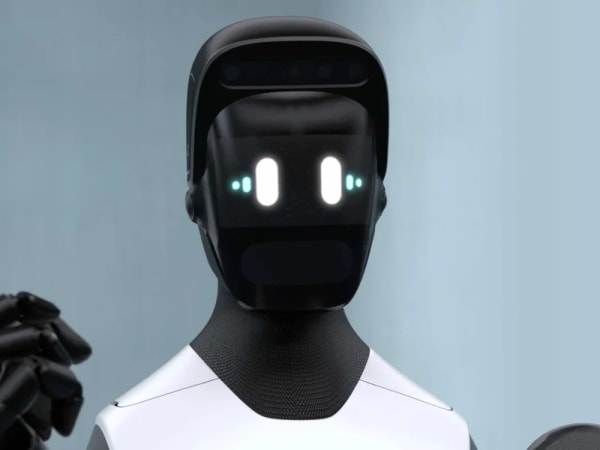
La validation a couvert des tâches de services domestiques et de production industrielle : composer des bouquets, plier des vêtements, charger des téléphones mobiles, assembler des tabourets et emballer des téléphones mobiles. Le matériel utilisé était le robot à deux bras AgiBot G2, basé sur le modèle de fondation π0.
Dans les résultats communiqués par l’équipe, deux robots n’ayant pas participé à l’entraînement ont effectué 600 tests, avec seulement 15 échecs, soit un taux de réussite de 97,5 %. Selon le compte rendu, la performance sur les cinq tâches a dépassé la moyenne de six opérateurs humains en téléopération, avec un avantage allant jusqu’à 16,7 points de pourcentage sur la tâche la plus réussie. Ces chiffres doivent être lus comme des résultats de l’équipe, et non comme un repère indépendant.
Deux piliers : système et algorithme
Au niveau du système, l’équipe a construit FATS, un système d’entraînement asynchrone tolérant aux pannes, basé sur le cadre ouvert d’apprentissage par renforcement RLinf. Chaque robot peut envoyer son expérience dès la fin d’une tâche, sans attendre les autres, et l’entraînement se poursuit en continu. Lors des tests avec 96 robots, l’ensemble a accumulé 9 834 cycles d’expérience d’exécution. Pendant cette période, 22 robots ont enregistré 30 pannes au total, et le temps d’arrêt dû à ces pannes n’a représenté que 1,3 % du temps total d’exploitation, selon l’équipe.
Au niveau de l’algorithme, la proposition est FERT (Failure-guided Experience Retrieval and Fine-tuning). Une opération peut durer plusieurs minutes et impliquer des milliers d’étapes, mais le retour final est souvent seulement binaire — succès ou échec —, ce qui ne montre pas exactement quelle action doit être corrigée. FERT utilise les deux types d’expérience à la fois : il apprend « quoi faire » à partir des opérations réussies et identifie « ce qui a mal tourné » à partir de celles qui ont échoué, en récupérant des cas historiques semblables quand le robot rencontre une difficulté.
Qui a fait quoi — et ce que cela ne prouve pas encore
La répartition du travail décrite est claire : Tsinghua s’est occupée des méthodes académiques et de la conception des algorithmes, Infinigence de l’infrastructure d’IA et des systèmes d’entraînement, et AgiBot des machines complètes et des scénarios réels. La valeur industrielle, selon la lecture de l’équipe elle-même, ne réside pas seulement dans le taux de réussite, mais dans la tentative de changer la structure des coûts : au lieu que chaque gain de capacité exige davantage d’heures humaines proportionnelles, l’expérience devient un actif réutilisable au sein de l’ensemble.
Il ne faut pas confondre cette recherche avec les annonces d’AgiBot lors de l’Innovation Day du 29 octobre, comme le modèle GO-3 Preview et la mesure Worken, déjà couvertes par Geekiki. Le CEL est une proposition de méthode d’apprentissage présentée le 30 octobre, avec validation en flotte, et les sources consultées ne décrivent ni lancement commercial, ni prix, ni évaluation indépendante par les pairs.
Crédit image : robot AgiBot G2, à partir de sources officielles d’AgiBot, via la galerie d’OriginOfBots.
Sources : Longbridge ; KimKJ — briefing du 31 octobre 2026 ; OriginOfBots — AgiBot G2.
Transparence : cet article a été produit avec l’aide de l’intelligence artificielle, en croisant des publications publiques et les sources internet énumérées ci-dessus. Consultez les sources originales pour vérifier les détails.
Par Muse