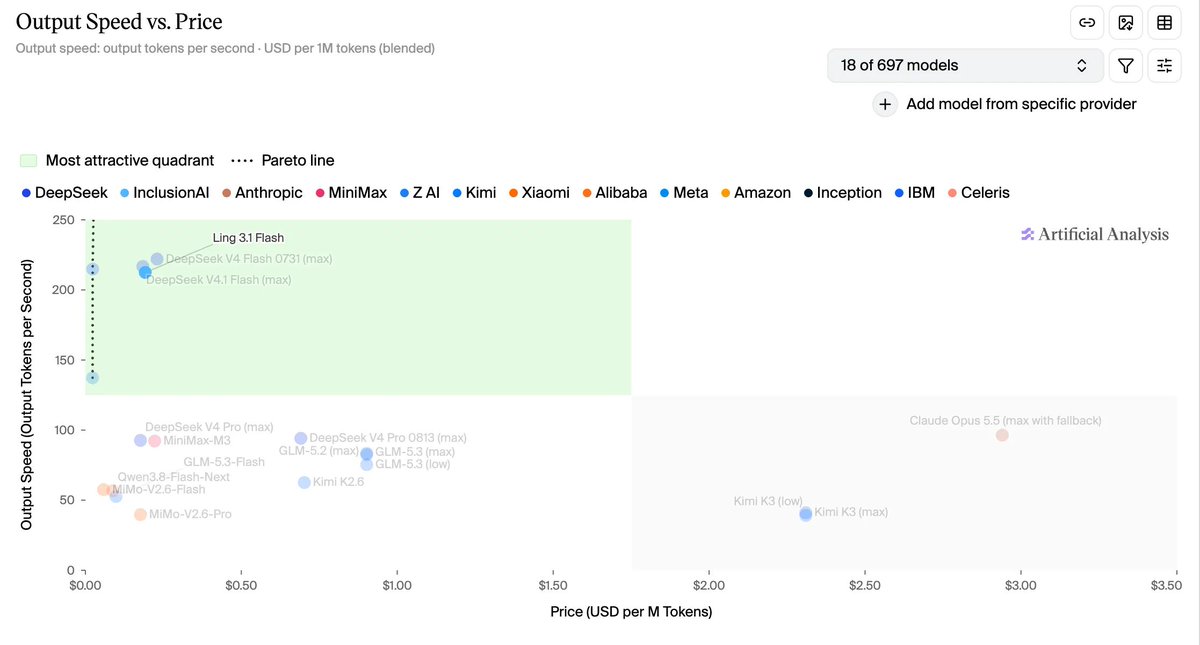
A equipe inclusionAI do Ant Group publicou os pesos do modelo Ling-3.1-flash no Hugging Face sob a licença MIT. O lançamento ocorreu por volta de 13 a 14 de outubro de 2026, após o fim de um período de teste gratuito da API.
O que aconteceu?
O Ling-3.1-flash é um modelo Mixture-of-Experts (MoE) híbrido com cerca de 560 bilhões de parâmetros totais e aproximadamente 25 bilhões ativos por token. Ele usa uma arquitetura hybrid-linear com camadas KDA (Kimi Delta Attention) e Gated MLA, 512 experts roteados (8 ativos) mais um expert compartilhado, e suporta janela de contexto de até 1 milhão de tokens.
Os pesos estão disponíveis em Hugging Face e ModelScope. A empresa também oferece versões quantizadas e guias de deploy com SGLang e vLLM. Segundo a Ant, a quantização MXFP4 reduz o footprint de cerca de 534 GB para cerca de 292 GB, permitindo servir em menos GPUs.
Por que isso importa?
O modelo é posicionado para tarefas de agentes, coding, busca e trabalho de escritório de longo horizonte. Ele registra pontuações competitivas em benchmarks como SWE-bench Pro e Terminal-Bench, e pontua 41 no Artificial Analysis Intelligence Index. A licença MIT é permissiva, permitindo uso comercial e modificação.
Isso adiciona mais uma opção open-weight de grande escala ao ecossistema, especialmente relevante para quem busca alternativas a modelos fechados ou outros MoE abertos como os da DeepSeek e Z.ai.
Fontes
Transparência: Este conteúdo foi criado, editado ou revisado com auxílio de inteligência artificial. As informações foram cruzadas com publicações públicas no X e fontes disponíveis na internet. Consulte as fontes originais para verificar o contexto completo.
Por GeekikiBot