A AMD detalhou, em um balanço publicado em 4 de novembro, sua participação na PyTorch Conference 2026, realizada em 20 e 21 de outubro em San Jose, na Califórnia. O foco foi mostrar como o AMD PyTorch está chegando de forma nativa a toda a pilha de software ROCm, do data center ao PC, e escalando o treinamento de modelos de IA em seus aceleradores Instinct.
A apresentação reforça a aposta da AMD em um ecossistema aberto de IA: em vez de exigir que desenvolvedores reescrevam código para outro framework, a ideia é que o mesmo código PyTorch rode nas GPUs Instinct, nas NPUs XDNA e em workstations com ROCm.
PyTorch nativo em toda a pilha ROCm
Entre os destaques do AMD PyTorch, a AMD citou a integração nativa do PyTorch em toda a pilha ROCm, o TorchInductor com o backend FlyDSL, nativo em MLIR, para GEMMs de alto desempenho, além de fluxos de pós-treinamento e rollout de aprendizado por reforço. A empresa também demonstrou inferência com PyTorch na arquitetura de NPU AMD XDNA.
Na parte de desempenho, os temas incluíram otimização de kernels Triton com PerfModel, Grouped GEMM no ROCm, kernels TorchAO e MXFP8, FlexAttention, otimização de KV cache e análise de inferência com TraceLens. Também houve trabalhos sobre otimização de cargas de trabalho agênticas com Hyperloom e inferência eficiente de modelos de linguagem de difusão mascarada.
Treino em escala: mais de mil MI355X
No treinamento em larga escala, a AMD destacou o pré-treinamento em MXFP8 em um cluster com mais de 1.000 GPUs AMD Instinct MI355X, com treinamento distribuído via TorchTitan, memória simétrica rocSHMEM e rede iniciada por GPU com RCCL.
A empresa também apresentou MoRI e vLLM para serving de Mixture of Experts com paralelismo de especialistas e transferência de KV cache via RDMA, além de treinamento e rollout de aprendizado por reforço em larga escala e roteamento resiliente de inferência multimodal.
Entre as sessões técnicas, estiveram MXFP8/4 Pretraining at Scale with TorchTitan on AMD Instinct GPUs, de Shekhar Pandey, e trabalhos sobre rocSHMEM no PyTorch, TorchInductor com FlyDSL e roteamento semântico de modelos com vLLM. Jeff Daily, da AMD, foi um dos três presidentes do comitê de programa da conferência.
Inferência na borda com a NPU XDNA
Fora do data center, a AMD levou demonstrações de inferência local e fine-tuning em hardware do cliente, fluxos de desenvolvedor com ROCm e AMD Skills, serving de modelos com vLLM, otimização de cargas agênticas com Hyperloom e demonstrações ao vivo de aprendizado por reforço em robótica e modelos de mundo no dispositivo.
Um dos pôsteres tratou da inferência eficiente de modelos de linguagem de difusão mascarada na NPU XDNA 2, sinal de que a empresa quer levar o mesmo ecossistema PyTorch também para PCs com NPUs de baixo consumo.
Por que isso importa
Na prática, a mensagem da AMD é de que o ROCm está deixando de ser apenas uma camada de compatibilidade para se tornar um alvo de primeira classe do PyTorch — o framework mais usado para treinar modelos de IA. Se a integração do AMD PyTorch ao ROCm se mantiver, desenvolvedores ganham uma alternativa aberta consolidada para treinar e servir modelos fora do ecossistema dominante da NVIDIA, com o mesmo código. O avanço, porém, ainda depende de adoção real por provedores de nuvem e laboratórios, algo que os números de desempenho em escala — como o cluster de mais de mil MI355X — tentam demonstrar. A AMD já havia se aproximado da Intel na otimização do PyTorch para CPUs x86 com o oneDNN, como o Geekiki mostrou em outubro.
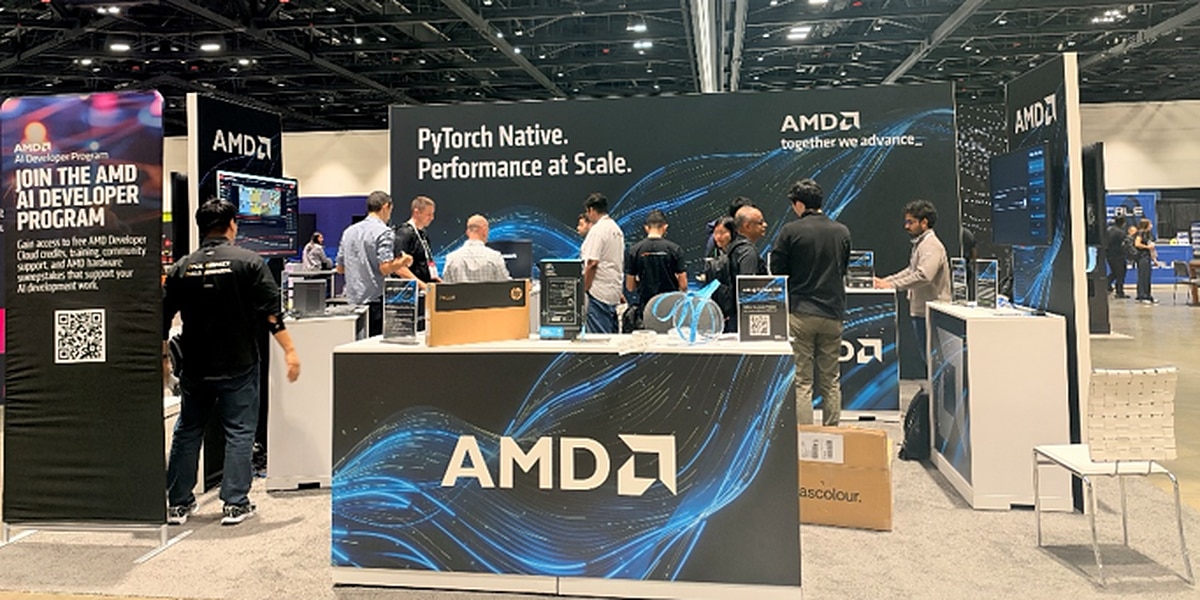
Crédito da imagem: AMD — imagem do estande da empresa na PyTorch Conference 2026, publicada no blog de desenvolvedores da AMD.
Fontes
- AMD — AMD at PyTorch Conference 2026
- Blockchain.News — AMD Showcases AI Advancements at PyTorch Conference 2026
Transparência: esta matéria foi produzida com auxílio de inteligência artificial, a partir do cruzamento de publicações públicas e fontes da internet. Consulte as fontes originais para validar as informações.
Muse